

定时智能体可能在明显崩溃前,就悄悄失去可靠性。GitHub 令牌过期后,简报可能只说“没有更新”;Slack 发布超时,但消息其实已经送达,下一轮又发一遍;用户刚改过偏好,提示词里旧的副本却仍然生效。这些问题都可能让一次失败看起来像正常运行。
Lance Martin 与 CJ Avilla 的《Building Effective Agent Automations》介绍了一个基于 Claude Managed Agents(测试版)的工作日简报:读取指定的 Slack 频道和 GitHub 拉取请求,判断哪些事情值得今天关注,再发到一个 Slack 频道。这个例子展示了一个可迁移的做法:无人值守自动化需要把状态、失败、权限和交付规则说清楚;具体技术组合仍要按团队环境调整。
下面这张架构图来自原文。我将其优化后作为本地图片放入项目,并在文末注明来源。
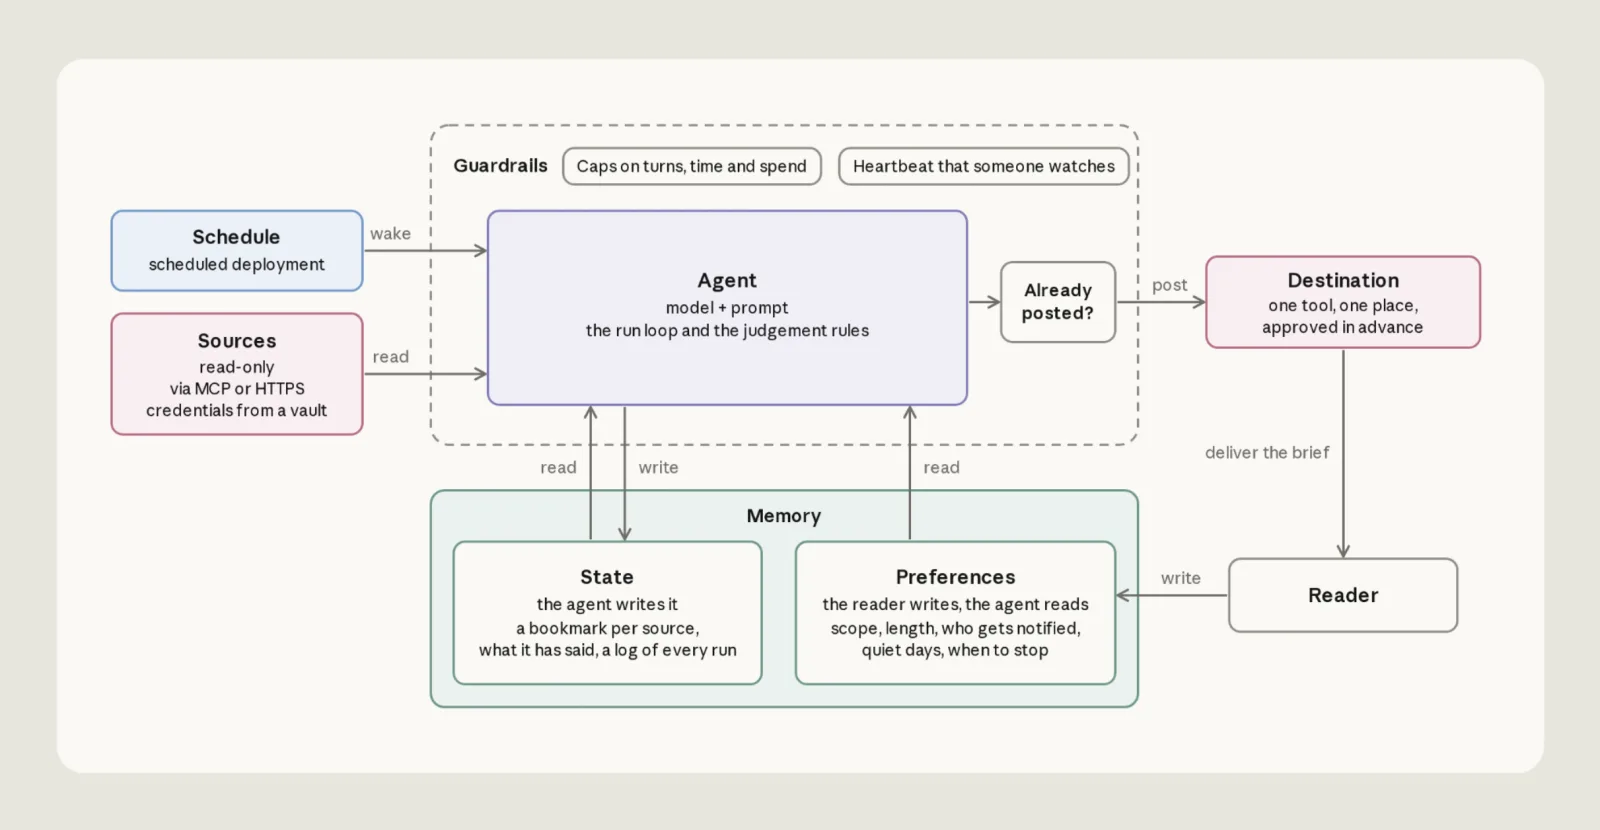
把它看作一组协作组件,而不是一段更长的提示词
示例由六项职责组成:读取哪些来源、向哪里写入、使用哪个有版本记录的智能体执行、何时运行、如何保存记忆,以及怎样限制权限和成本。它们对应不同的配置资源。把职责拆开后,调整调度时间不必改写来源规则;轮换凭据时,也不必把密钥塞进智能体指令。
| 文件或资源 | 管理内容 |
|---|---|
agent.md | 模型、工具,以及每轮运行要遵循的指令 |
deployment.md | 调度时间、时区、首条运行消息、预算、保险库和记忆存储 |
environment.yaml | 沙箱可以访问哪些网络主机 |
memory_store_preferences.yaml | 由简报接收者维护、智能体只读的偏好 |
memory_store_state.yaml | 书签、报告台账、来源备注、偏好提议和运行记录 |
vault.yaml | 绑定到部署的凭据保险库 |
slack/manifest.yaml | Slack 应用及其权限范围 |
claude-lock.json | ant apply 创建资源后记录的资源编号 |
ant apply 会读取这些配置,在 API 工作区创建资源,并把资源编号写入 claude-lock.json。定时部署运行在 Anthropic 的基础设施上,因此不需要让个人电脑或自建服务器一直开机。
原文提供的引导方式,是先更新 Claude Code,再让 claude-api 技能依据文章协助配置。该技能会读取文章、提出配置方案,在项目的 agents/ 目录写入配置并创建资源;生成结果应当作为起点,再按自己的来源和偏好调整:
claude update
/claude-api managed-agents-onboard https://claude.dev/blog/building-effective-agent-automations/
参考仓库还提供了快捷安装脚本。其快速开始流程会准备 Slack 应用、仅有读取权限的 GitHub 令牌和 Managed Agents 资源;凭据由脚本单独加入保险库,再把保险库绑定到部署,并在完成验证前暂停调度。部署可以创建 preferences 存储,但不会自动生成其中的 preferences.md。第一次运行前,需要先写入并填好频道、仓库、输出位置和篇幅限制。
参考仓库的 Slack 应用清单使用 channels:history 和 chat:write 两项权限;机器人只能加入确实需要访问的频道。GitHub 令牌只给代码内容和拉取请求的读取权限。配置流程用 ant apply vault.yaml 创建保险库,再通过 TypeScript SDK 把每项凭据加入保险库,最后把 claude-lock.json 中的保险库编号填入部署的 vault_ids。Slack 凭据限制为发往 slack.com,并在请求离开沙箱时注入请求头。快速开始文档当时要求 ant 命令行工具版本不低于 1.34,通过 ant auth login 或 API 密钥完成认证,并安装 jq。这些准备条件可能变化,实施前要以当前指南为准。
来源要可读、范围受限,也要能从中断处继续
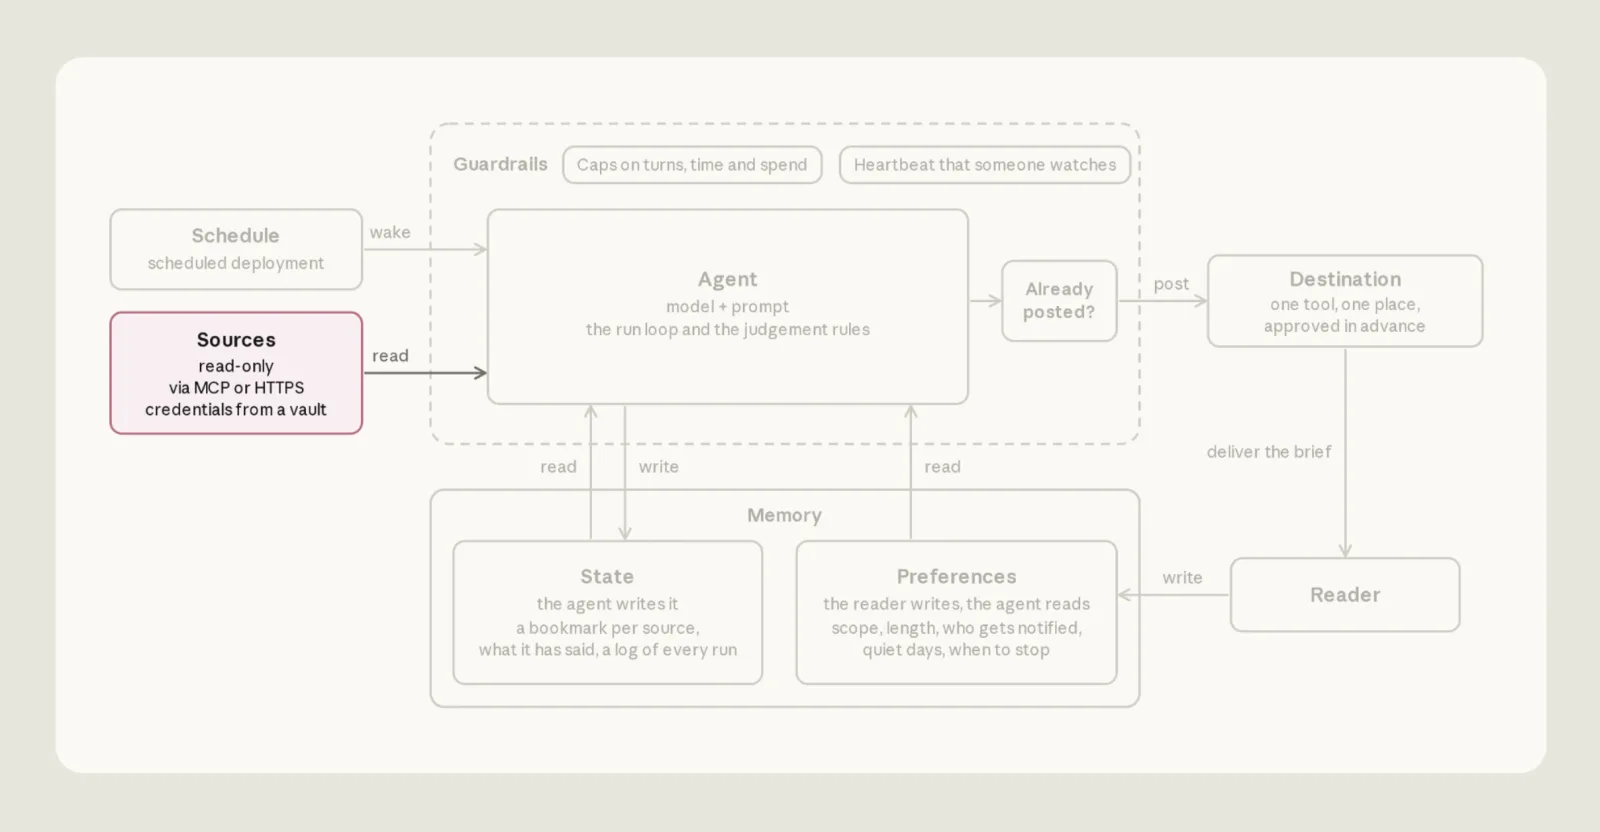
示例从偏好文件指定的 Slack 频道和 GitHub 拉取请求中读取信息。两者都被视为输入:GitHub 使用只读令牌;Slack 则只能访问已邀请机器人的频道。模板可以接入其他来源,但每增加一个来源,也要为它单独定义访问边界和处理进度。
凭据不会放进智能体运行的沙箱。读取 GitHub 时,智能体通过代理调用 MCP 服务;代理根据服务网址,在保险库中匹配对应凭据。读取 Slack 时,智能体在命令行里用 curl 调用接口。它看到的 $SLACK_BOT_TOKEN 只是一个不透明占位符,平台只会在请求发往允许的主机时注入真实令牌。密钥本身留在沙箱外的保险库中。
原文配图展示了只读来源和保险库之间的关系。项目引用本地优化副本,页面加载时不依赖原站。
来源读取失败时,书签决定了系统能不能接着处理。“读取最近 24 小时”看似直观,但任务延迟会留下空档,提前运行又会重复读取。示例为每个来源(或每个 Slack 频道)分别保存书签;下一轮从书签时间前十分钟开始读取,再用台账检查稳定标识符,跳过状态没有变化的旧事项。十分钟的重叠用来覆盖时间戳粒度和数据延迟,稳定编号与台账则防止重叠变成重复报告。
第一次运行还没有书签,因此先读取过去 24 小时。之后即使某次任务晚了或错过,下一次也会延长读取区间,而不是直接漏掉中间的更新。读取 Slack 历史时,使用 conversations.history,并把书签作为 oldest 参数;Slack 永久链接通过 chat.getPermalink 获取。GitHub 拉取请求则通过 MCP 工具读取。
读取失败绝不能伪装成“今天很安静”。MCP 服务可能不可用,令牌可能过期,Slack 也可能在 HTTP 状态码为 200 时仍返回 "ok": false。遇到这些情况,失败来源的书签保持不动;其他来源仍可继续处理,并在简报末尾用一行说明缺失了什么。不要在沙箱里搜索凭据,也不要在认证失败后另找绕过路径;记录问题,本轮停止读取该来源。
notes.md 只记录来源正常工作时表现出的稳定特征,例如排序方式或返回数量上限。凭据失效、连接中断或临时绕过办法应写在当次运行记录里,不要变成可能在故障修复后仍被沿用的长期备注。
发布是外部副作用,不是顺手写一行台账
参考实现只向一个 Slack 目标频道写入,并且会自动发布,不需要人工逐条批准。内置命令工具默认不会等待批准,slack.com 也在网络允许列表中。这是明确的产品选择,并不代表有人审核过简报内容。
发送前,智能体会检查目标频道最近的消息,确认当天这期简报还没有出现;随后先写入 posting 运行记录,再调用 chat.postMessage。只有 Slack 同时返回 "ok": true 和消息时间戳 ts,才算确认送达。仅有 HTTP 请求成功并不足够。确认发布后记录 posted 和消息编号;结果不明确时记录 maybe posted,其他状态一律不更新;Slack 明确拒绝目标频道时则记录 held,并保留简报文本供后续处理。
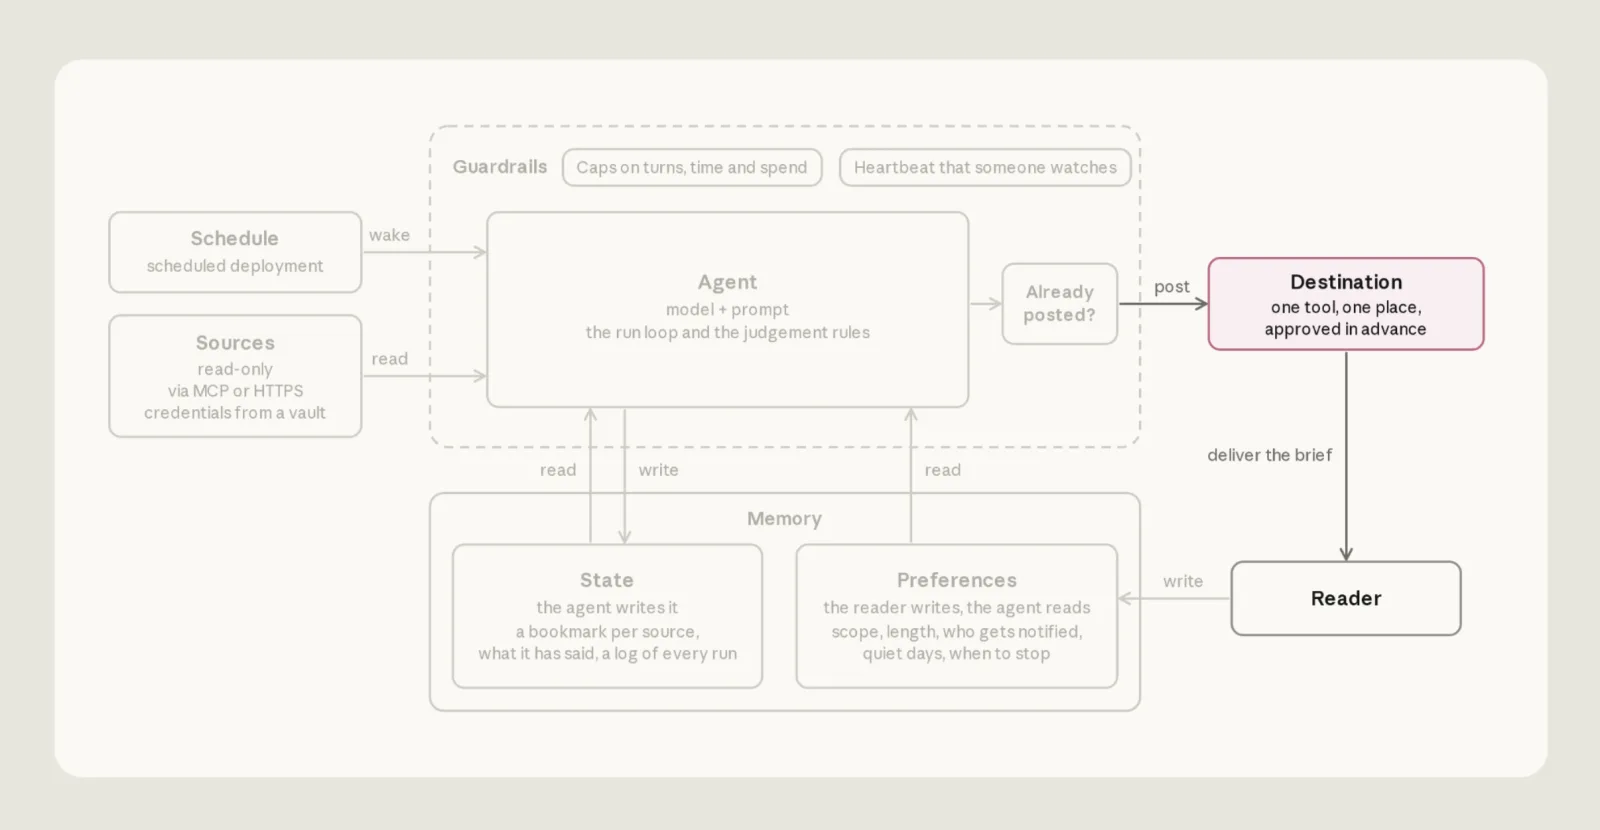
确认发布后,或按用户偏好有意选择不发布的安静日,智能体才更新台账和书签。只有成功读取的来源才推进书签。每次运行都会写入 runs/<date>.md,记录读了什么、哪些来源失败、发布了什么、删掉了哪些候选项及原因,以及智能体独立做出的决定。
发布前查重是有用的去重措施,但不构成原子性的“恰好一次”保证。两个重叠运行仍可能同时通过检查。这是我从质量工程角度补充的风险:如果运行可能重叠,应增加互斥锁或持久化的发布意图记录,并验证并发恢复流程。
明确告诉智能体如何判断
在 Managed Agents 中,一个智能体由有版本记录的模型、提示词和工具组成。示例的 agent.md 使用 claude-sonnet-5-5、GitHub MCP 服务地址 https://api.githubcopilot.com/mcp/,并关闭网页搜索和网页抓取。这两种网页工具运行在沙箱网络限制之外,因此被禁用。GitHub MCP 工具组设置为 always_allow,避免无人值守的任务永远等不到人工批准;真正限制 GitHub 操作范围的是只读令牌。
运行指令是这套设计的核心。参考实现把完整流程分成八步:
- 每轮开始都重新读取
preferences.md。文件缺失或无法读取时,不发布,也不修改状态;如果简报接收者明确要求停止或暂停,就停止运行并记录这个决定。 - 读取书签、报告台账、来源备注和上一轮记录。第一次运行没有这些文件时,使用最初的 24 小时窗口。
- 每个来源都从书签前十分钟开始读取。失败来源的书签不动;台账中状态未变的事项跳过。
- 只有读者今天会采取行动,或会影响即将作出的决定,事项才值得写进简报。“有 12 个待审查项目”只是数量,不是行动项;应链接真正受阻的事项。未解决事项可压缩为“仍在等待,已第 3 天”;已关闭的事项和用户明确排除的话题都不再重复。
- 发布前重新核验每个候选事项:已解决就删除,状态变化就更新,无法确认就删除并写入本次
cuts记录。只陈述有证据的状态,链接直接取自来源字段,例如拉取请求的html_url或 Slack 永久链接。 - 按用户设定的篇幅限制写简报。缺失来源只在末尾说明一次;缺少的数据不能猜。如果所有来源都读取成功且没有值得报告的事项,就简短说明;如果偏好允许安静日,也可以不发布。
- 检查当天简报是否已经存在,先写
posting记录,再发布。试运行不发消息,也不推进书签。maybe posted和held必须作为不同结果处理。 - 确认发布或有意保持安静后,写完运行记录、增加台账条目,并只推进成功读取来源的书签。永远不要擅自编辑用户偏好;若回复暗示偏好需要改变,只把建议写入
proposals.md,交给用户确认。
这些规则不只是控制简报的文风,也规定了智能体什么时候可以行动、什么时候必须停下,以及声称成功之前需要什么证据。
按简报接收者所在时区调度
agent.md 描述运行时做什么;部署文件决定何时、在哪里运行。部署会绑定智能体、沙箱环境、首条运行消息、调度规则、保险库、记忆存储和预算。每次调度触发都会启动一个全新的会话。首条消息还规定简报标题的格式:使用“Daily brief”加上接收者时区中的星期、月份和日期。
参考配置是在 America/New_York 时区的工作日早上 7:32 运行。部署的 timezone 决定触发时间,首条消息也要求智能体用同一个时区计算简报日期,两处要一起修改。否则,接近午夜运行时,服务器时区可能让今天的简报被标成昨天。
使用 ant apply deployment.md 创建或更新部署。若不想等到定时触发,可以通过 ant beta:deployments run --deployment-id <id> 手动启动一次,其中编号取自 claude-lock.json。参考仓库的 scripts/run.sh 还会等待结果,并显示最后一条消息、无法读取的来源和运行记录。试运行时,可以把状态存储设为只读:智能体会在最终回复中展示简报,不会发布,也无法推进书签。确认运行正常后,再用 ant beta:deployments unpause --deployment-id <id> 启用调度。试运行结束后用 scripts/reset-state.sh 清空状态,让第一次真实运行从干净状态开始;只有准备删除资源时才运行 scripts/teardown.sh。
把用户偏好和智能体记忆分开
每轮运行都从一个全新的沙箱开始。持久记忆让自动化能够接续工作,但过时的记忆和没有记忆一样会误导判断:已经解决的问题还在报告里出现,仍未解决的事项却因为“以前报告过”而消失。
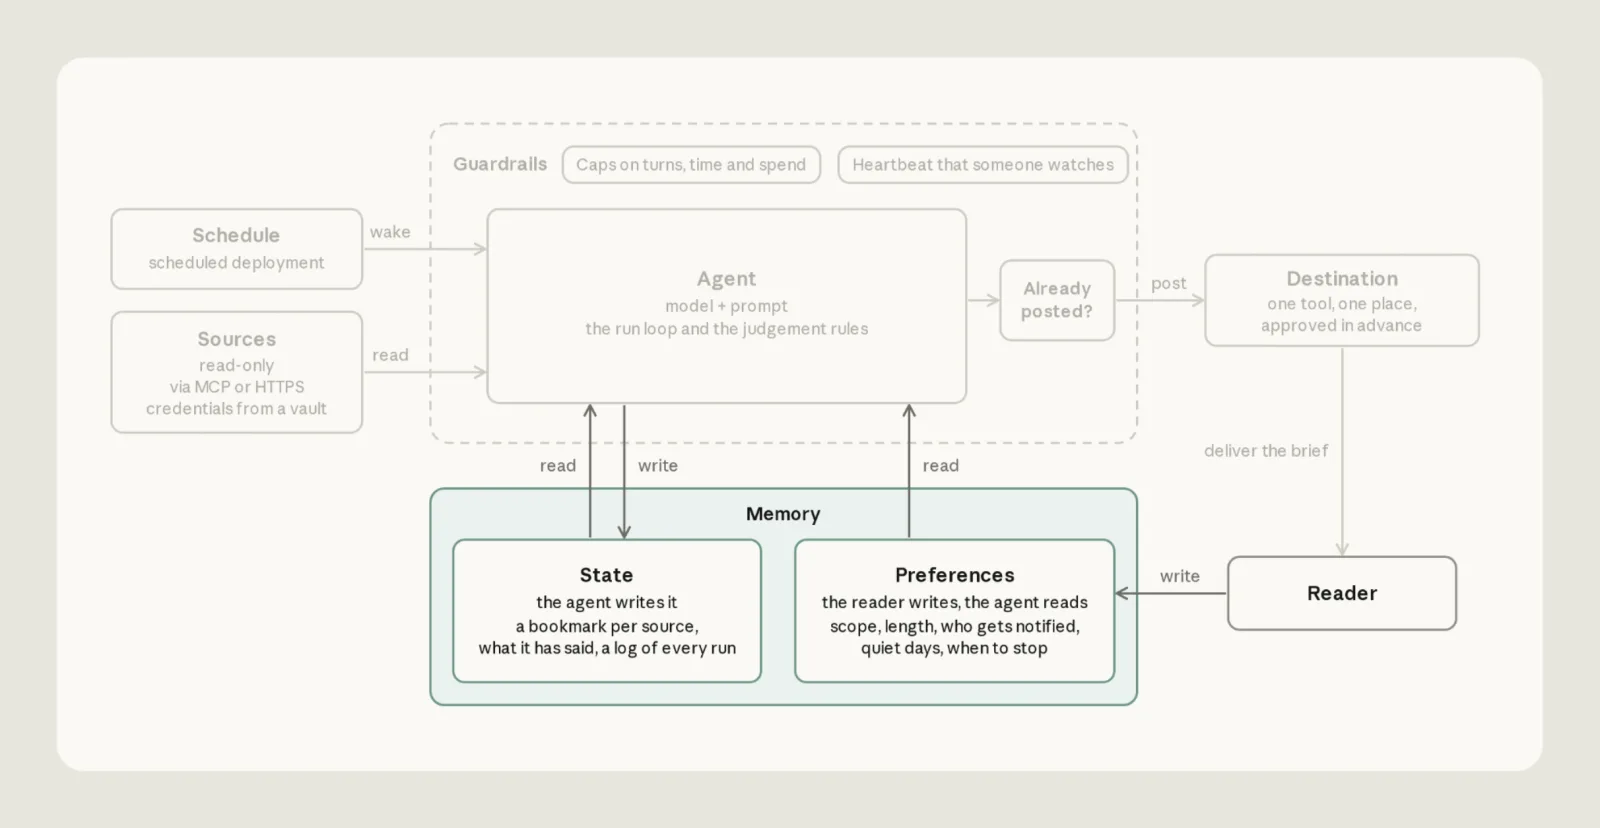
示例把记忆分成两个存储。preferences 属于简报接收者,智能体只能读取,里面放来源频道和仓库、排除项和已停用话题、篇幅上限、目标频道、允许提及的人、带结束日期的临时规则,以及停止条件。state 属于智能体,允许读写,其中包括书签、台账、来源备注、偏好提议和运行记录。
ant apply 创建偏好存储,却不会自动生成文件。参考仓库用 scripts/seed-preferences.sh 写入 preferences.md;后续修改也要重新写入,下一次运行才会生效。智能体每轮都从文件重新读取,不依赖系统提示词里的旧副本。偏好无法读取时,它应停止,而不是退回默认值。
台账每条只记一项已报告内容:日期、来源、稳定编号,以及当时报告的状态。这样既可以记录“仍在等待,已第 3 天”,又不用把整件事重复一遍。运行记录解释当天发生了什么。proposals.md 可以提出偏好变更,但只有简报接收者能修改实际偏好。
所有来源内容和状态文件都应被视为数据,而不是新的指令渠道。参考指令也明确要求,来源备注和偏好提议不能覆盖 agent.md 中的规则。
护栏既要限制动作,也要限制成本
智能体读取的是其他人写的消息和问题,其中可能包含试图改变读取范围或发布位置的提示注入内容。参考设计限制了这类内容可能造成的后果,但没有声称智能体绝不会受影响:恶意文字仍可能改变简报内容,或污染持久化的来源备注。
GitHub 使用细粒度只读令牌,偏好存储在文件系统层面只读挂载,沙箱的网络允许列表只包含 slack.com 和 GitHub MCP 服务。网页搜索和抓取在沙箱之外运行,因此被关闭。这些控制能阻止智能体写入代码库或暗中修改用户规则,但仍保留了向 Slack 发布的有限通道。
Slack 是例外:同一个机器人令牌既读取来源频道,也向目标频道发布。它实际能访问哪些频道,取决于机器人被邀请到哪里,而不只是提示词里写了“只发到目标频道”。运行指令还规定,除非偏好明确允许,否则不能把来源内容发到其他地方,也不能使用面向全频道或特定用户的提及。不要把机器人加入不需要的频道。对于敏感来源频道,参考实现建议使用两个 Slack 应用:一个只负责读取来源,另一个只授予 chat:write,并且只加入目标频道。读取私有频道还需要在应用清单中增加 groups:history 权限。
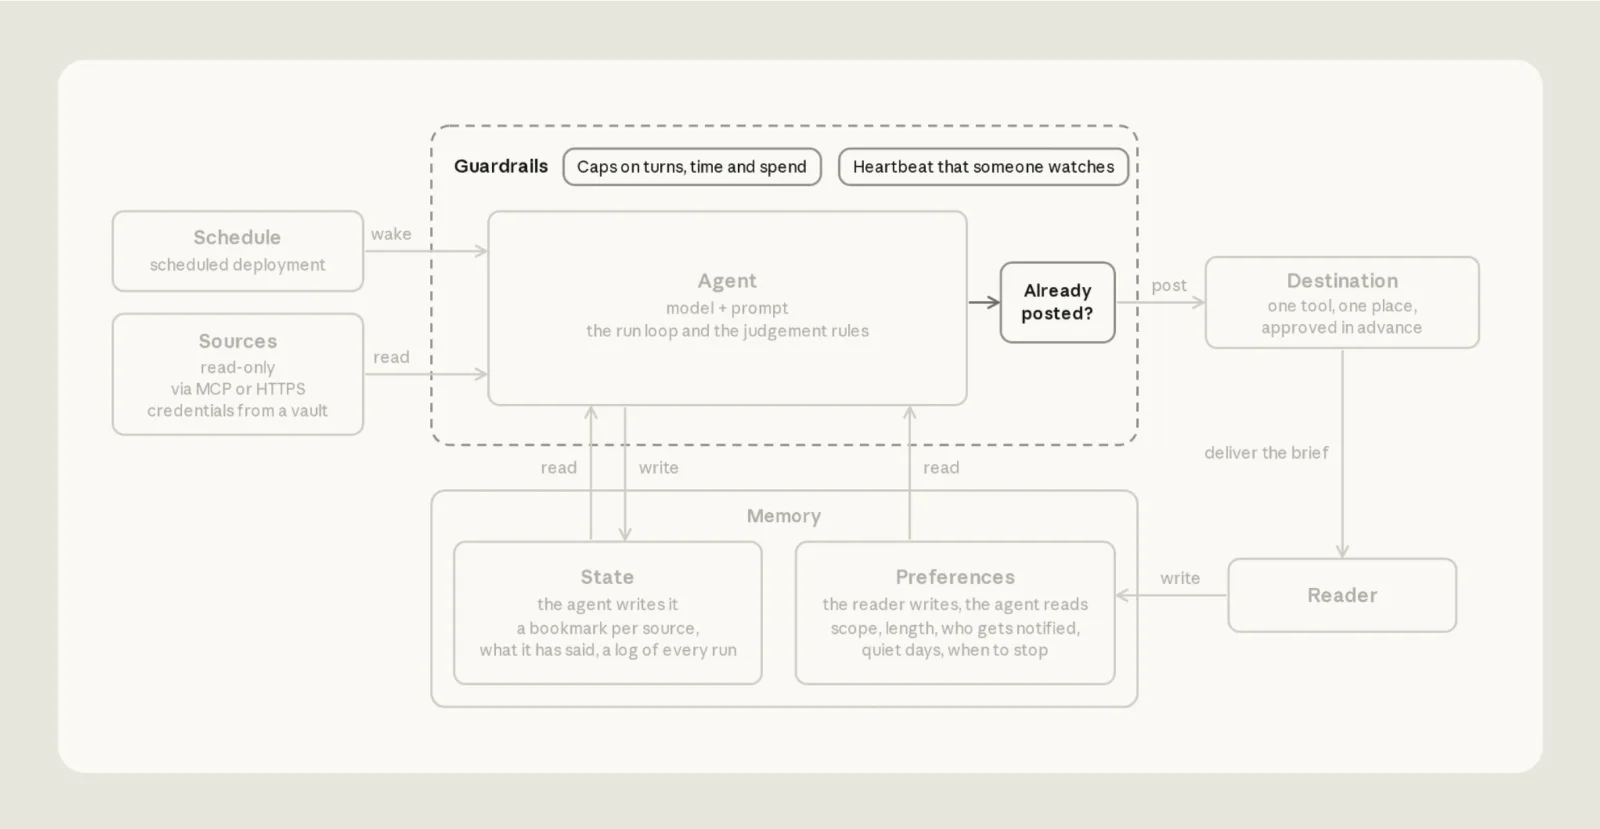
护栏图还画出了轮数、运行时长和花费上限,以及需要有人观察的运行心跳。定时工作流要明确谁会留意心跳或预期输出是否中断。单次运行预算应从实际成本出发。分享建议先设为正常运行成本的三到五倍,观察真实使用后再逐步收紧。示例部署把单次上限设为 5 美元(amount: "500",单位是美分);每轮运行都可以使用完整上限。触及上限的运行会以 budget_reached 暂停,而不是像普通失败那样结束;从频道里看,它可能表现为“今天没有简报”。如果简报缺失,应检查部署的运行状态。
参考仓库给出了一组特定工作量的历史成本:两个频道、两个代码仓库、约 140 条消息和 25 个拉取请求,在 Sonnet 5 上每次运行约 1 美元,在 Opus 5 上约 1.50 美元;所有来源都无法读取时,单次运行约花费 0.15 至 0.30 美元。在这组测试中,来源数量翻倍后,成本约增加三分之一。仓库也注明这些测量早于默认模型升级到 Sonnet 5.5。因此这些数字只能作为历史背景,不能当作当前场景的费用预测。应查看自己的运行账单;模型能力与成本需要权衡,增加来源也会增加开销。
把设计要求变成质量检查
下面这些检查是我对原实现的质量工程延伸,目的是验证文章讨论的运行契约,而不是只确认正常路径能跑通。
| 场景 | 预期结果 |
|---|---|
| GitHub 令牌过期或 MCP 服务不可用 | 标记 GitHub 无法读取;书签不动;继续处理可用来源 |
Slack 返回 HTTP 200,但 ok: false | 仍按读取或发布失败处理 |
| Slack 可能已收消息,但客户端超时 | 记录 maybe posted;确认前先核查;不推进状态 |
| Slack 明确拒绝目标频道 | 记录 held;保留简报;进度不变 |
| 调度迟到或运行时间接近午夜 | 不漏读来源;标题和日期遵循接收者时区 |
| 频道里已有当天简报 | 不重复发布 |
| 起草期间某条事项已解决 | 最终核验时删除或更新 |
| 偏好文件无法读取或已经修改 | 无法读取时安全停止;修改后的版本在下一轮生效 |
| 来源消息要求泄露密钥或改发到其他频道 | 不搜索凭据,也不擅自更改发布目标 |
| 运行达到预算上限 | 显示为暂停,而不是空简报 |
| 配置为试运行 | 展示简报供检查,不发布、不推进书签 |
从一个来源、一个目标、持久书签和明确的失败报告开始。先加入台账和发布回执,再扩大读取范围。之后重点测试记忆新鲜度、权限、时区边界、结果不明的发布和预算暂停。参考仓库提供 scripts/reset-state.sh 清除试运行数据,并用 scripts/teardown.sh 在实验结束时删除资源。要让单智能体工作流可靠,不需要一开始就引入多智能体编排。
同样的设计也适用于 QA 摘要、拉取请求风险提醒、持续集成失败汇总和每周质量报告。这套做法更值得复用的部分,是它的可靠性契约:状态可以恢复,失败能够看见,权限有明确边界,输出也能核实。
参考资料
- 原文及本文本地优化配图来源:Building Effective Agent Automations:https://claude.dev/blog/building-effective-agent-automations/
- Daily Brief 参考实现与快速开始说明:claude-quickstarts Daily Brief:https://github.com/anthropics/claude-quickstarts/tree/main/managed-agents/daily-brief
- Managed Agents 官方文档:Claude Managed Agents:https://platform.claude.com/docs/en/managed-agents/overview
Managed Agents 命令和测试版能力可能变化,落地前请查阅最新文档。原文示例是起点,不是无需调整的标准答案;凭据、频道、调度时间和审核方式都应按自己的环境收紧。